
Was RAG ist — und warum das Modell nicht Ihre Daten lernt
Retrieval-Augmented Generation in einem Absatz
Bei RAG (Retrieval-Augmented Generation) wird das Sprachmodell nicht mit Ihren Daten trainiert. Stattdessen werden Ihre Dokumente in Abschnitte zerlegt, als Vektoren in einer Suchdatenbank abgelegt und bei jeder Frage die passendsten Abschnitte herausgesucht. Erst diese Abschnitte bekommt das Modell zusammen mit der Frage — und formuliert daraus eine Antwort mit Quellenangabe.Das hat drei Vorteile: Neue Dokumente sind sofort durchsuchbar, ohne Training. Jede Antwort ist auf die Quelle zurückführbar. Und Zugriffsrechte bleiben erhalten — wer ein Dokument nicht sehen darf, bekommt auch keine Antwort daraus.
So gehen wir vor: in fünf Schritten zur Wissensdatenbank
Vom ersten Gespräch bis zum Betrieb
| Schritt | Was passiert | Dauer |
|---|---|---|
| 1. Quellen sichten | Welche Systeme (Dateiserver, SharePoint, Confluence, ERP, Ticketsystem), welche Formate (PDF, Word, Excel, E-Mail, Scans), welche Rechte. Wir sagen ehrlich, was sich lohnt und was nicht. | 1 Woche |
| 2. Prototyp | Ein Ausschnitt Ihrer Daten, ein lokales Modell, eine einfache Chat-Oberfläche. Sie stellen echte Fragen aus dem Alltag und sehen, wie gut die Antworten sind. | 2-4 Wochen |
| 3. Anbindung | Automatischer Import aus Ihren Systemen, Rechteübernahme (z. B. aus Active Directory), Verarbeitung von Tabellen, Scans und Bildern, Aktualisierung bei Änderungen. | 3-8 Wochen |
| 4. Integration | Chat im Intranet, in Teams, im ERP oder als Schnittstelle für Ihre eigene Software. Auf Wunsch Sprachsteuerung oder Anbindung an Exponate. | 2-4 Wochen |
| 5. Betrieb | Modell-Updates, Qualitätsmessung anhand echter Fragen, Erweiterung um neue Quellen. Läuft auf Ihrer Hardware, gewartet von uns. | laufend |
Lokal, Cloud oder hybrid?
Eine ehrliche Gegenüberstellung
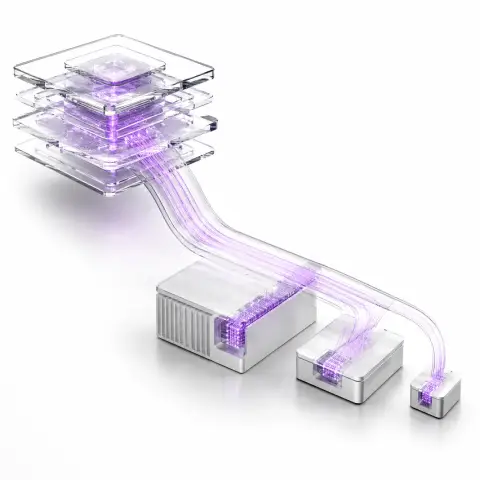
Lokale Open-Source-Modelle (Qwen, Llama, Mistral, Gemma — betrieben über Ollama oder vLLM) laufen vollständig auf Ihrer Hardware. Ihre Daten verlassen das Haus nicht, es fallen keine API-Kosten pro Anfrage an, und die Lösung funktioniert auch ohne Internet. Die Antwortqualität liegt unter den großen Cloud-Modellen, reicht für Dokumentensuche, Zusammenfassungen und interne Assistenten aber in den meisten Fällen aus — vor allem, weil bei RAG die Qualität der Suche wichtiger ist als die des Modells.Cloud-Modelle (OpenAI, Anthropic, Google) liefern die beste Sprachqualität und sind schnell eingebunden, schicken aber jede Anfrage samt Dokumentausschnitten an den Anbieter — mit Auftragsverarbeitung machbar, für viele Kunden trotzdem ein Ausschlusskriterium.
Hybrid heißt: Suche und sensible Daten lokal, nur unkritische Formulierungsaufgaben in die Cloud. Wir bauen alle drei Varianten und empfehlen nach Ihrem Schutzbedarf, nicht nach Mode.
Welche Hardware braucht ein lokales LLM?
Richtwerte für den Betrieb im Unternehmen
| Einsatz | Hardware | Modelle | Richtpreis Hardware |
|---|---|---|---|
| Prototyp / bis 5 Nutzer | Workstation mit einer GPU (16-24 GB VRAM) | 7B-14B-Modelle, z. B. Qwen 2.5 14B, Llama 3.1 8B | 3.000 - 6.000 € |
| Abteilung / bis 50 Nutzer | Server mit einer GPU (48-80 GB VRAM) | 30B-70B-Modelle, quantisiert | 10.000 - 25.000 € |
| Unternehmensweit | Server mit 2-4 GPUs, redundant | 70B-Modelle in voller Qualität, mehrere Modelle parallel | 30.000 - 80.000 € |
| Nur Suche, ohne Chat | vorhandener Server, CPU reicht | Embedding-Modell ohne LLM | meist 0 € |

Was eine Wissensdatenbank kostet
Und woran Projekte in der Praxis scheitern
Ein Machbarkeits-Prototyp mit einem Ausschnitt Ihrer Daten beginnt bei uns unter 3.000 €. Eine produktive Wissensdatenbank mit Anbindung an zwei bis drei Quellsysteme, Rechteübernahme und Intranet-Integration liegt typischerweise zwischen 15.000 und 50.000 €, dazu die Hardware aus der Tabelle oben. Laufende Kosten: Strom, Wartung, Modell-Updates — keine Gebühren pro Anfrage.Woran es in der Praxis scheitert, ist selten das Modell: Es sind veraltete Dokumente, die dem aktuellen widersprechen, Scans ohne Text, Tabellen, die als Bild vorliegen, und Rechte, die niemand mehr pflegt. Deshalb beginnt jedes Projekt bei uns mit der Sichtung der Quellen — und einer ehrlichen Aussage, welche davon ein Aufräumen brauchen.
Häufige Fragen zu KI-Wissensdatenbanken mit lokalen LLMs
Was Kunden uns zu RAG, Ollama und Datenschutz fragen
Wie kann ich das interne Wissen meiner Firma mit KI durchsuchbar machen?
+
Mit einer RAG-Wissensdatenbank: Ihre Dokumente aus Dateiserver, SharePoint, Wiki oder ERP werden in eine Vektor-Suchdatenbank übernommen. Ein Sprachmodell beantwortet Fragen in natürlicher Sprache und nennt die Quelle. Das Modell muss dafür nicht trainiert werden, neue Dokumente sind sofort verfügbar. Wir setzen das mit lokal betriebenen Modellen um, sodass keine Daten das Unternehmen verlassen.
Können LLMs wirklich ohne Cloud betrieben werden?
+
Ja. Open-Source-Modelle wie Qwen, Llama, Mistral oder Gemma laufen über Ollama oder vLLM vollständig auf Ihrer eigenen Hardware — von der Workstation bis zum GPU-Server. Es gibt keine Verbindung nach außen, keine Kosten pro Anfrage und keine Auftragsverarbeitung, die Sie regeln müssen.
Wie gut sind lokale Modelle im Vergleich zu ChatGPT?
+
Bei freier Textproduktion liegen die großen Cloud-Modelle vorn. Bei einer Wissensdatenbank zählt aber vor allem, ob die richtigen Dokumentabschnitte gefunden werden — und das leistet die Suche, nicht das Modell. Mit einem guten 14B- bis 70B-Modell erhalten Sie für Dokumentensuche, Zusammenfassung und interne Assistenten Antworten, die im Alltag vollkommen ausreichen. Wir zeigen Ihnen den Unterschied im Prototyp an Ihren eigenen Fragen.
Welche Quellen könnt ihr anbinden?
+
Dateiserver und Netzlaufwerke, SharePoint und OneDrive, Confluence und andere Wikis, E-Mail-Postfächer, Ticketsysteme, ERP- und CRM-Datenbanken, Webseiten und Handbücher — als PDF, Office-Dokumente, Scans (mit Texterkennung), Tabellen und Bilder. Was es als Datenbank oder Schnittstelle gibt, können wir anbinden.
Bleiben Zugriffsrechte erhalten?
+
Ja, das ist Pflicht. Wir übernehmen die Berechtigungen aus Ihren Quellsystemen (z. B. Active Directory, SharePoint-Rechte) und filtern bei jeder Frage, bevor das Modell Dokumente sieht. Ein Mitarbeiter bekommt nur Antworten aus Dokumenten, die er auch direkt öffnen dürfte.
Was kostet eine RAG-Wissensdatenbank?
+
Der Machbarkeits-Prototyp beginnt unter 3.000 €. Eine produktive Lösung mit Anbindung an zwei bis drei Quellsysteme, Rechteübernahme und Integration ins Intranet liegt typischerweise zwischen 15.000 und 50.000 €, plus Hardware zwischen 3.000 € (Workstation) und 25.000 € (Abteilungsserver). Nach dem kostenlosen Erstgespräch nennen wir Ihnen eine konkrete Zahl.
Wie lange dauert es bis zum ersten Ergebnis?
+
Ein Prototyp mit einem Ausschnitt Ihrer Daten steht in 2 bis 4 Wochen. Die produktive Lösung inklusive Anbindung und Integration dauert je nach Anzahl der Quellsysteme 2 bis 4 Monate.
Ist eine lokale KI-Wissensdatenbank DSGVO-konform?
+
Sie ist die datenschutzfreundlichste Variante: Keine Übermittlung an Dritte, keine Auftragsverarbeitung, Datenminimierung durch Rechtefilter und Protokollierung der Zugriffe. Für den EU AI Act ordnen wir Ihr Vorhaben in die Risikoklasse ein — interne Wissensassistenten fallen in der Regel in die niedrigste.
Der kostenlose KI-Check für Ihre Wissensdatenbank
In 30 Minuten wissen Sie, ob sich das für Sie lohnt
Schildern Sie uns, wo Ihr Wissen liegt und wer es sucht — wir sagen Ihnen, ob eine lokale Wissensdatenbank sinnvoll ist, welche Hardware Sie brauchen und was der Prototyp kostet. Mehr zu unserer KI-Entwicklung.

 Anrufen
 WhatsApp
 E-Mail


